


Test de PRA - définir et vérifier les RTO et RPO par service
Un site de secours qui démarre ne suffit pas. RTO, RPO, dépendances et tests métier : comment vérifier que chaque service peut réellement reprendre.
Mardi, 09h00. Le site de secours démarre. À 10h26, l’essai de reprise s’interrompt. Une licence dépend de l’adresse IP du serveur principal. La procédure de démarrage d’une stack Docker n’est connue que d’une personne.
C’est le cas partagé par Hugo Cloez, président fondateur de Forget About IT, à propos d’un test de reprise pour un acteur logistique. Le matériel de secours était là. Les dépendances nécessaires pour rendre le service, elles, n’étaient pas toutes maîtrisées. Lire son retour sur LinkedIn.
Un PRA non testé reste une intention.
Cette phrase résume le sujet. Un test de plan de reprise d’activité, ou PRA, ne consiste pas simplement à redémarrer des machines. Il doit vérifier que chaque service reprend dans son délai cible, avec une perte de données acceptable. Deux objectifs servent à le mesurer : le RTO et le RPO. Et ces objectifs doivent être définis par service, pas une fois pour toute l’entreprise.
Consulter le carrousel RTO/RPO et tests de PRA en PDF.
RTO : mesurer jusqu’au retour du service, pas jusqu’au démarrage du serveur
Le RTO, pour Recovery Time Objective, fixe le délai de reprise visé. La question est simple : combien de temps ce service peut-il rester indisponible ?
Un RTO de quatre heures ne donne pas quatre heures pour restaurer une base. Tout ce qui sépare l’incident du retour du service consomme ce délai :
- Détecter et qualifier l’incident.
- Décider de déclencher la reprise et mobiliser les intervenants.
- Accéder aux consoles, aux sauvegardes et aux secrets nécessaires.
- Restaurer et redémarrer les composants dans le bon ordre.
- Basculer les accès, le réseau ou le DNS.
- Valider avec le métier que le service est utilisable.
Une VM démarrée n’est donc pas la ligne d’arrivée. Pour un service logistique, il faut par exemple pouvoir retrouver une commande, enregistrer une opération et poursuivre le traitement attendu. Le critère de réussite se définit avec les utilisateurs, avant le test.
Dans le test évoqué en introduction, la licence de l’application était liée à l’adresse IP du serveur principal. Si le serveur de secours utilise une autre IP, cette licence peut empêcher l’application de fonctionner, même après une restauration réussie. Il faut donc prévoir les conditions d’utilisation de la licence sur le secours et les vérifier pendant l’exercice. Le RTO porte sur le service rendu, pas sur la seule restauration technique.
RPO : quelle perte de données peut-on accepter ?
Le RPO, pour Recovery Point Objective, fixe le point de récupération attendu. On l’exprime généralement en durée : un RPO d’une heure signifie accepter de perdre au maximum une heure de données ou de saisies.
Prenons un exemple : l’incident survient à 14h00, mais le dernier point cohérent que l’on peut restaurer date de 13h15. La perte potentielle couvre 45 minutes. Si l’objectif du service était de 15 minutes, il n’est pas tenu, même si la restauration fonctionne parfaitement.
Il faut donc regarder le dernier point réellement récupérable, pas seulement la fréquence prévue des sauvegardes. Une tâche programmée toutes les heures ne prouve rien si la dernière copie a échoué, si le dépôt est inaccessible ou si les données restaurées ne sont pas cohérentes.
Le glossaire du NIST sur le RPO rappelle cette notion de point dans le temps à retrouver après une interruption. Nos stratégies de sauvegarde avec Proxmox Backup Server abordent les moyens de conserver et de vérifier ces points de restauration.
Première erreur : un seul RTO et un seul RPO pour toute l’entreprise
« Notre RTO est de quatre heures. » Pour quel service ? À quelle période ? Avec quelle perte de données ?
La paie, le site vitrine et l’ERP n’ont pas les mêmes besoins. Leur appliquer un objectif global peut conduire à surdimensionner le secours d’un service secondaire tout en sous-estimant les exigences d’un service critique.
Voici un exemple de cadrage à adapter avec les métiers :
| Service | Objectif RTO | Objectif RPO |
|---|---|---|
| ERP et opérations logistiques | 2 heures | 15 minutes |
| Paie, hors échéance critique | 8 heures | 1 heure |
| Site vitrine sans transaction | 24 heures | 24 heures |
Ce tableau sert à ouvrir la discussion, pas à la remplacer. Un site qui porte des commandes n’a pas le même rôle qu’un site de présentation.
Pour chaque service, le cadrage doit préciser :
- l’impact d’une interruption et les éventuels modes dégradés ;
- la perte de données acceptable et les moyens de ressaisie ;
- les dépendances nécessaires à la reprise ;
- la personne qui décide et celle qui valide le retour du service ;
- le budget cohérent avec les objectifs retenus.
Un délai court peut demander une capacité préprovisionnée, des données disponibles plus rapidement et davantage d’automatisation. La bonne architecture découle des besoins métier. Elle ne commence pas par un chiffre global choisi pour être rassurant.
Deuxième erreur : confondre deux hébergeurs et deux domaines de panne
Deux opérateurs cloud différents peuvent héberger leurs équipements dans le même datacenter. Les contrats et les interfaces changent, mais le site physique reste commun. Une panne à l’échelle de ce datacenter peut alors rendre indisponibles la plateforme principale et son secours en même temps.
Pour un PRA, il faut donc vérifier où se trouvent réellement les ressources, pas seulement le nom du fournisseur. Le secours doit se trouver dans un autre datacenter pour couvrir la perte du site principal. Il faut aussi examiner les dépendances communes entre ces sites, notamment l’alimentation électrique et les accès réseau.
Cette séparation physique doit rester exploitable : si l’accès au secours exige un VPN hébergé sur le site perdu, ou si les sauvegardes ne sont accessibles que depuis ce site, la reprise reste bloquée.
Pendant le test, il faut donc vérifier la reprise sans les dépendances que le scénario suppose perdues :
- localisation des ressources et disponibilité du secours en cas de perte du datacenter principal ;
- accès d’administration de secours et authentification ;
- réseau, résolution DNS et moyens de bascule ;
- accès aux sauvegardes, aux clés et aux images nécessaires ;
- licences, droits d’usage et contacts fournisseurs.
La réplication ne remplace pas une sauvegarde. Elle peut aussi propager une suppression, une corruption ou un chiffrement malveillant. Il faut conserver des points de restauration protégés, avec une rétention adaptée et des accès séparés.
Nous détaillons les choix de site, de provider et de niveau de préparation dans notre article sur une infrastructure de PRA réellement indépendante. Ici, le test doit apporter la preuve que cette indépendance fonctionne.
Comment mener un test de PRA utile
Le but d’un exercice n’est pas d’obtenir un compte rendu tout vert. Il est de trouver les blocages avant la crise. La licence et la procédure Docker découvertes pendant l’essai logistique sont précisément le type de dépendances qu’un test doit faire ressortir.
1. Choisir un service et un scénario précis
Commencez par un service critique et définissez ce qui devient indisponible : une VM, un site complet, un compte cloud ou l’accès au réseau principal. Un test de perte de datacenter ne doit pas continuer à utiliser discrètement les services de ce datacenter.
Fixez le RTO, le RPO, les critères métier et les limites de l’exercice. Une restauration isolée peut éviter de toucher la production ; elle ne valide pas, à elle seule, toute la bascule des utilisateurs.
2. Faire exécuter la procédure par une autre personne
Une procédure connue d’une seule personne est une dépendance humaine. Un bon exercice vérifie qu’un autre intervenant peut suivre les étapes, retrouver les accès et comprendre les contrôles attendus.
Pour une stack Docker, cela inclut les fichiers de déploiement, les versions d’images, les volumes persistants, les secrets, les migrations et les dépendances applicatives. Des conteneurs en cours d’exécution ne suffisent pas à valider le service.
Ce travail rejoint la cartographie des dépendances avant une reprise d’infogérance : réseau, données, fournisseurs et personnes doivent apparaître dans le même raisonnement.
3. Chronométrer la chaîne et vérifier les données
Horodatez les étapes : alerte, décision, accès, restauration, bascule et validation. Si l’exercice commence directement à la restauration, les étapes amont restent à mesurer ou à simuler pour évaluer le délai complet.
Relevez aussi le point de données effectivement restauré. Vérifiez la cohérence des fichiers, bases et traitements liés. Une application qui affiche des données récentes mais incohérentes n’a pas repris correctement.
4. Faire valider un parcours métier
La validation doit porter sur une action utile : ouvrir un dossier, traiter une commande, générer un document ou exécuter une opération prévue dans le scénario. Vérifiez aussi les échanges avec les autres services.
La CNIL recommande de tester la restauration et les plans de continuité ou de reprise, avec les parties prenantes. Le succès d’un exercice ne se résume pas au résultat d’une commande de démarrage.
5. Préparer le retour à la normale
Une fois le secours actif, des données continuent d’être créées. Le retour sur la plateforme nominale doit prévoir leur resynchronisation, les conditions de bascule et les contrôles pour éviter une perte ou un double traitement.
Le PRA doit permettre de reprendre, puis de revenir à un fonctionnement durable.
Après le test : corriger, rejouer et maintenir
Chaque blocage doit produire une action avec un responsable et une échéance : adapter une licence, documenter le démarrage, corriger les accès ou revoir la capacité du secours. Puis il faut rejouer le point concerné.
Les objectifs se confrontent aux mesures. Si le délai constaté dépasse le RTO, on ajuste l’architecture, la procédure ou l’objectif avec le métier. On ne conserve pas simplement le chiffre initial dans le document.
Les tests doivent revenir selon un calendrier adapté à la criticité, mais aussi après une migration, un changement réseau, une évolution applicative importante ou une forte croissance des données. Un PRA se maintient comme le reste de l’infrastructure.
Le carrousel RTO/RPO à consulter et partager
Le support en six pages reprend les définitions, le délai complet de reprise, les objectifs par service et les pièges de la réplication et des dépendances communes.
Télécharger le carrousel PRA - RTO et RPO par service (PDF, 6 pages)
Utilisez les flèches pour parcourir les six pages, ou faites-les glisser sur mobile. Cliquez sur une page pour l’agrandir et poursuivre la lecture en grand.
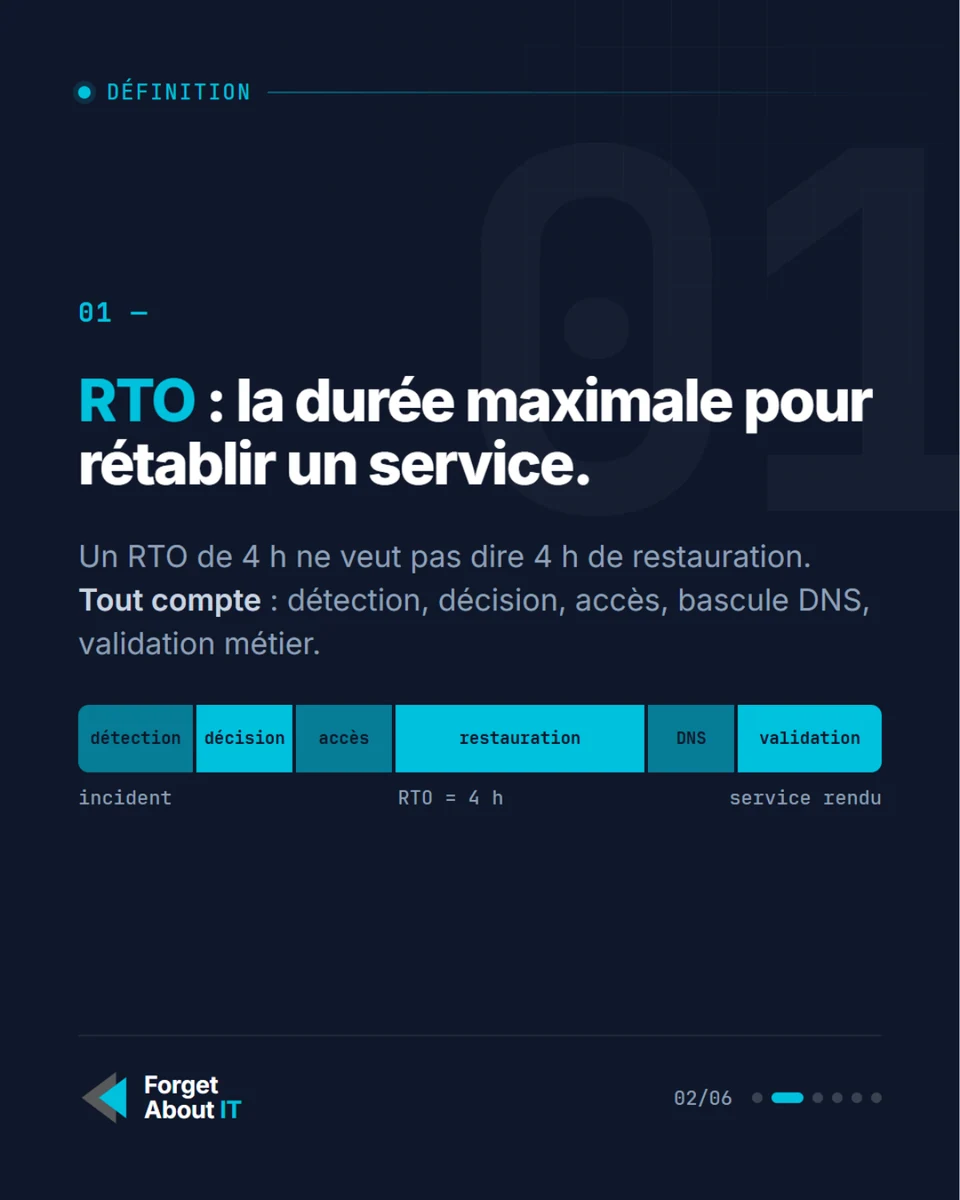
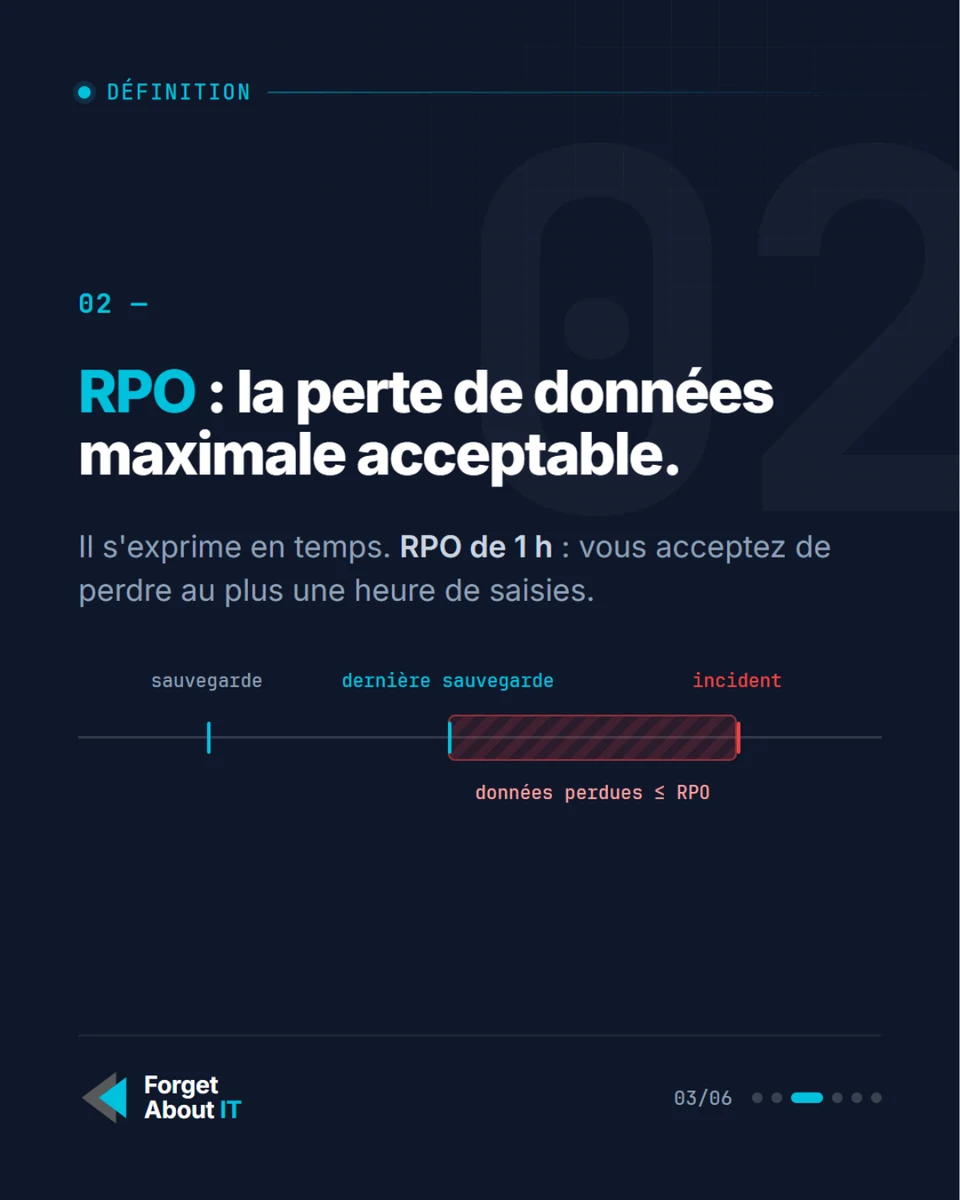
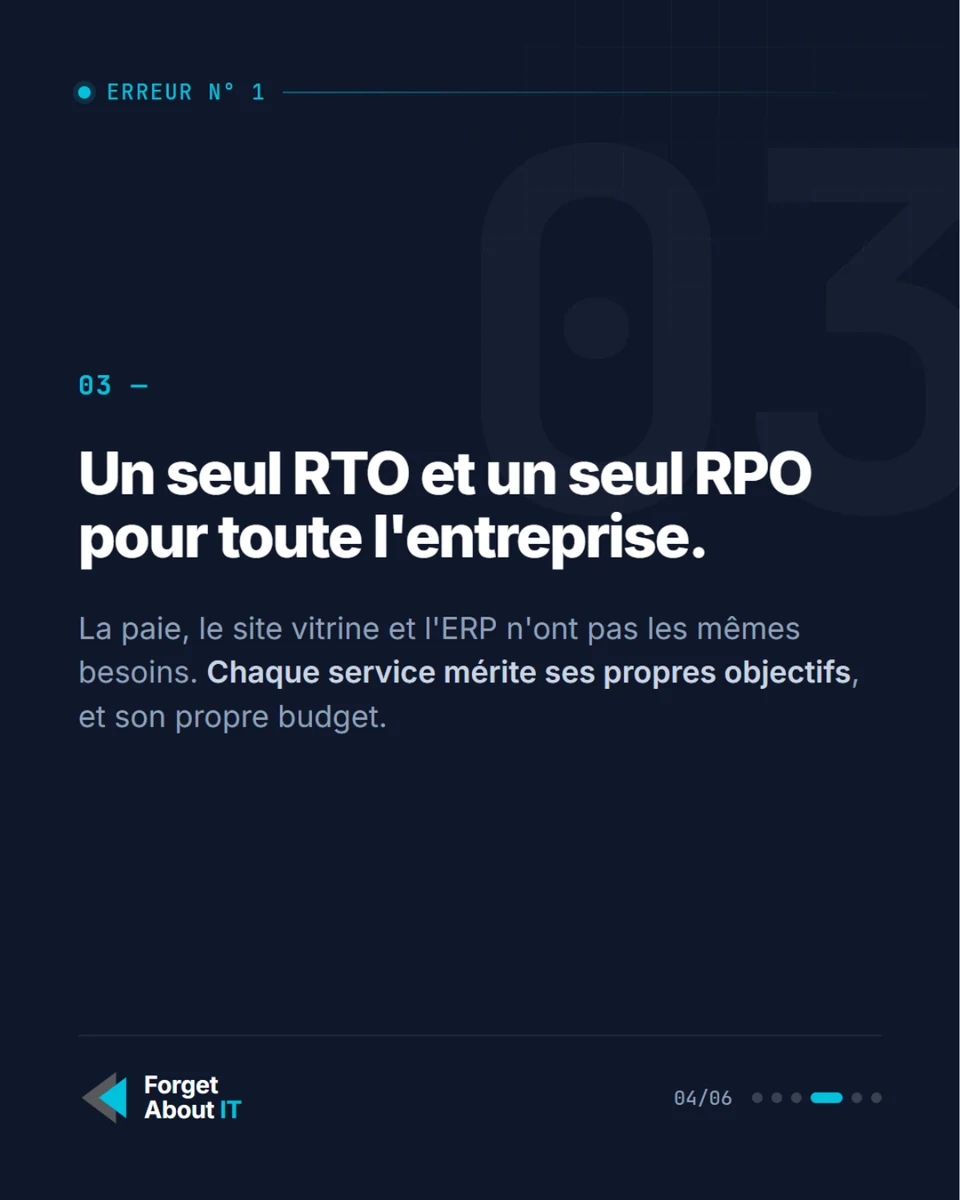
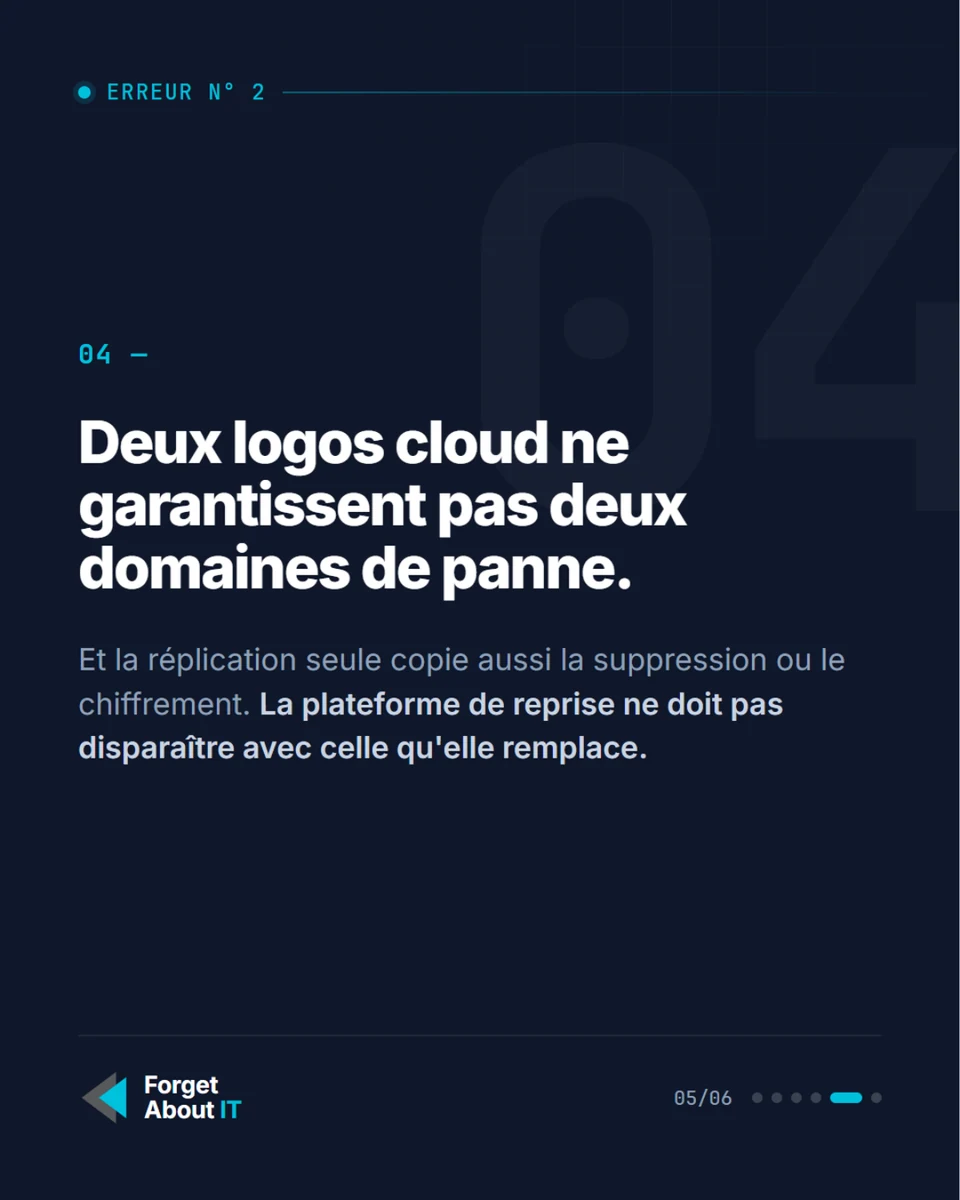
Vous pouvez aussi ouvrir directement le carrousel au format PDF.
Tester votre PRA sur votre infrastructure réelle
Nous concevons et testons des PRA sur des environnements OVHcloud, Scaleway, IONOS ou Castle IT, en partant des services à rétablir et des dépendances à lever.
Le travail porte sur les objectifs par service, les sauvegardes, les accès de secours, les licences, les procédures et les essais métier. Notre infogérance de serveurs Linux permet ensuite de faire vivre ce dispositif avec les évolutions de la production.
Quand avez-vous testé votre PRA pour la dernière fois ? Et surtout : quels RTO et RPO avez-vous réellement vérifiés, pour quels services ?
Questions fréquentes
Pourquoi définir les RTO et RPO par service ?
Parce que les conséquences d’une interruption ou d’une perte de données diffèrent entre un ERP, la paie et un site vitrine. Chaque service doit avoir ses objectifs, ses dépendances, un responsable de validation et un budget adapté.
Un RTO de quatre heures autorise-t-il quatre heures de restauration ?
Non. Le délai de reprise doit intégrer la détection, la décision, les accès, la restauration, la bascule réseau ou DNS et la validation métier. Le service doit être utilisable dans ce délai, pas seulement son serveur démarré.
Comment vérifier le RPO pendant un test de PRA ?
Il faut identifier le dernier point de données réellement restauré et cohérent, puis mesurer son écart avec l’heure de l’incident simulé. La fréquence prévue des sauvegardes ne suffit pas si une copie a échoué ou n’est pas restaurable.
Deux hébergeurs garantissent-ils un PRA indépendant ?
Non. Deux opérateurs cloud peuvent héberger leurs équipements dans le même datacenter et subir la même panne de site. Il faut vérifier la localisation réelle du principal et du secours, leur séparation physique et les dépendances nécessaires à la reprise.
Quand faut-il tester son PRA ?
Selon un calendrier adapté à la criticité des services, après une évolution importante et après correction d’un blocage découvert en exercice. Les tests doivent mesurer les délais, vérifier les données et inclure une validation métier.
Sources et support
Suivre nos publications
Retrouvez plus facilement nos analyses dans Google
Ajoutez Forget About IT à vos sources préférées pour signaler à Google que vous souhaitez voir davantage nos contenus.
Articles recommandés
Infrastructure
Grafana - une supervision plus lisible avec le panneau Text dynamique
Grafana fait évoluer son panneau Text en préversion : des synthèses alimentées par les données pour mieux lire l'état des sauvegardes, des services et de la capacité.
Infrastructure
Gitea 28.0 - audit et CI/CD pour votre forge Git auto-hébergée
Journaux d'audit, comptes d'automatisation et pipelines mieux suivis : Gitea 28.0 renforce la maîtrise d'une forge Git hébergée sur votre infrastructure.
Infrastructure
Création de site internet avec maintenance - Agence 200
Forget About IT lance Agence 200 : création de sites vitrines, refonte et applications sur mesure, avec une équipe qui assure aussi le suivi technique.